Quand je réalise un audit technique pour un client, l'un des premiers fichiers que je consulte est le robots.txt. Ce petit fichier texte, posé à la racine de votre site, joue un rôle disproportionné par rapport à sa taille : il indique aux robots des moteurs de recherche quelles parties de votre site ils peuvent parcourir et lesquelles ils doivent laisser de côté. Un fichier robots.txt mal configuré peut, en une seule ligne, empêcher Google d'explorer l'intégralité de vos pages et faire disparaître votre site des résultats de recherche. À l'inverse, un fichier bien pensé aide les moteurs à concentrer leurs efforts sur ce qui compte vraiment. Dans cet article, je vous partage ma manière de comprendre et de configurer ce fichier, avec les nuances qui font toute la différence entre un site correctement exploré et un site qui se sabote sans le savoir.
Qu'est-ce que le fichier robots.txt et à quoi sert-il ?
Le fichier robots.txt est un fichier au format texte brut, placé à la racine de votre nom de domaine, accessible à l'adresse votresite.fr/robots.txt. Il obéit à un standard appelé le protocole d'exclusion des robots, né dans les années 1990 et aujourd'hui formalisé par un document technique reconnu par les principaux moteurs. Son principe est simple : avant de parcourir un site, un robot bien élevé commence par lire ce fichier pour connaître les règles de la maison.
Il faut bien comprendre que ce fichier fonctionne comme un panneau d'indication, pas comme une barrière verrouillée. Les robots légitimes comme Googlebot ou Bingbot respectent scrupuleusement ses consignes, mais un robot malveillant ou un aspirateur de contenu peut tout à fait les ignorer. Le robots.txt n'est donc en aucun cas un outil de sécurité : il ne protège pas des pages sensibles et ne remplace jamais une authentification. Je le répète souvent en formation, car c'est une confusion fréquente qui peut avoir des conséquences graves. Si une page contient des informations confidentielles, elle doit être protégée par un mot de passe, pas par une simple ligne dans un fichier public que n'importe qui peut consulter.
L'intérêt principal du robots.txt tient en un mot : le budget de crawl. Google alloue à chaque site une quantité de ressources limitée pour l'explorer. En interdisant l'exploration de zones inutiles pour le référencement — pages de tri, filtres de recherche interne, espaces d'administration, versions dupliquées — vous évitez que les robots gaspillent leur temps et les orientez vers vos contenus stratégiques. Sur un petit site vitrine, l'enjeu reste modeste. Sur un site e-commerce de plusieurs milliers de pages, il devient déterminant.
Il faut aussi savoir que le robots.txt est le tout premier fichier que la plupart des robots consultent en arrivant sur un domaine. Avant même de parcourir votre page d'accueil, Googlebot va chercher ce fichier et met en cache son contenu pendant un certain temps. Cela signifie qu'une modification n'est pas prise en compte instantanément : il peut s'écouler un délai avant que le moteur relise votre fichier. J'en tiens toujours compte quand je débloque un site, car il ne faut pas s'attendre à un retour immédiat dans les résultats. La patience fait partie du métier, et comprendre ce fonctionnement de mise en cache évite bien des inquiétudes inutiles lorsqu'un changement met quelques jours à produire pleinement ses effets sur l'exploration.
La syntaxe de base : comprendre les directives
Le robots.txt repose sur une grammaire volontairement minimaliste. Chaque bloc de règles commence par une ligne User-agent qui désigne le robot concerné, suivie d'une ou plusieurs directives qui précisent ce qu'il a le droit de faire. La logique se lit de haut en bas, robot par robot.
La directive User-agent identifie le robot visé. La valeur User-agent: * s'adresse à tous les robots sans distinction, tandis que User-agent: Googlebot ne concerne que le robot d'exploration de Google. Vous pouvez ainsi définir des règles différentes selon les moteurs, même si dans la grande majorité des cas une règle universelle avec l'astérisque suffit largement.
La directive Disallow est le cœur du fichier : elle indique un chemin que le robot ne doit pas explorer. Par exemple, Disallow: /wp-admin/ demande de ne pas parcourir le dossier d'administration de WordPress. Un Disallow: / tout seul, lui, interdit l'exploration de tout le site — c'est justement la ligne qui provoque les catastrophes dont je parlerai plus loin. À l'inverse, un Disallow: laissé vide n'interdit rien du tout et autorise donc tout.
La directive Allow fonctionne comme une exception à un Disallow. Elle permet de rouvrir un chemin précis à l'intérieur d'un dossier par ailleurs bloqué. Un cas classique : bloquer un dossier entier tout en autorisant un sous-dossier ou un fichier particulier qu'on souhaite voir explorer. C'est un outil de précision que j'utilise régulièrement pour affiner les règles sans tout casser.
Deux caractères spéciaux complètent cette grammaire. L'astérisque * remplace n'importe quelle suite de caractères, ce qui permet par exemple de bloquer toutes les URL contenant un point d'interrogation avec Disallow: /*?. Le symbole $ marque la fin d'une URL, utile pour cibler un type de fichier précis comme Disallow: /*.pdf$. Enfin, la directive Sitemap, indépendante des blocs User-agent, indique l'adresse de votre plan de site XML pour aider les moteurs à découvrir vos pages.
Un point mérite d'être précisé, car il déroute souvent les débutants : lorsqu'une URL correspond à plusieurs règles à la fois, c'est la règle la plus spécifique qui l'emporte, c'est-à-dire celle dont le chemin est le plus long. Ainsi, un Allow ciblant un fichier précis prend le dessus sur un Disallow visant le dossier entier qui le contient. Cette logique de priorité au chemin le plus long est ce qui rend possibles les configurations fines, où l'on bloque une zone tout en gardant une porte ouverte pour un élément particulier. Je conseille toutefois de rester sobre : plus les règles se croisent, plus le risque d'un comportement inattendu augmente. Un fichier lisible par un humain est un fichier fiable pour un robot.
| Directive | Rôle | Exemple | Effet |
|---|---|---|---|
| User-agent | Désigne le robot concerné par les règles suivantes | User-agent: * | Les règles s'appliquent à tous les robots |
| Disallow | Interdit l'exploration d'un chemin | Disallow: /panier/ | Le dossier /panier/ n'est pas exploré |
| Disallow (vide) | N'interdit rien | Disallow: | Tout le site est autorisé à l'exploration |
| Disallow: / | Interdit tout le site | Disallow: / | Aucune page n'est explorée : à manier avec prudence |
| Allow | Rouvre un chemin dans une zone bloquée | Allow: /wp-admin/admin-ajax.php | Ce fichier reste accessible malgré un Disallow parent |
| Sitemap | Indique l'adresse du plan de site XML | Sitemap: https://site.fr/sitemap.xml | Aide les moteurs à découvrir les pages |
La différence essentielle entre robots.txt et noindex
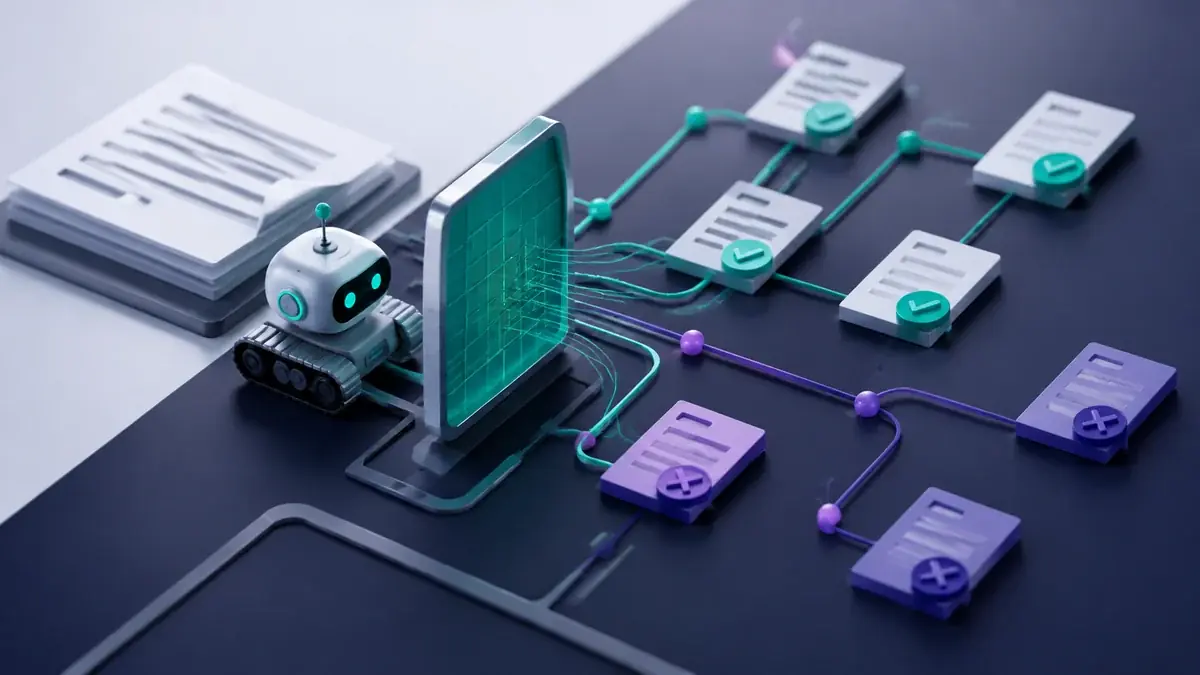
C'est sans doute le point le plus mal compris de tout le sujet, et pourtant il est fondamental. Beaucoup de personnes pensent que bloquer une page dans le robots.txt suffit à la faire disparaître de Google. C'est faux, et cette confusion produit régulièrement l'effet inverse de celui recherché. Je prends toujours le temps de bien l'expliquer, car les deux mécanismes agissent à des étapes complètement différentes.
Le robots.txt agit sur l'exploration (le crawl) : il empêche le robot de lire le contenu d'une page. La balise meta noindex, elle, agit sur l'indexation : elle autorise le robot à lire la page, mais lui demande de ne pas la faire figurer dans les résultats de recherche. Ce sont deux verbes différents : explorer, c'est parcourir ; indexer, c'est ranger dans la base de données du moteur.
Le piège est le suivant : si vous bloquez une page dans le robots.txt, Google ne peut plus la lire. Donc il ne peut plus voir la balise noindex que vous auriez placée dessus. Résultat, si des liens externes pointent vers cette page, Google peut malgré tout l'afficher dans ses résultats, avec un libellé du type « Aucune information n'est disponible pour cette page », faute d'avoir pu en lire le contenu. Vous obtenez alors le pire des deux mondes : une page visible dans les résultats mais sans description soignée.
La règle que j'applique est donc claire. Pour empêcher une page d'apparaître dans les résultats de recherche, j'utilise la balise noindex dans le code de la page, et surtout je laisse le robots.txt autoriser son exploration afin que Google puisse voir cette consigne. Pour économiser du budget de crawl sur des zones sans intérêt pour le référencement — filtres, paniers, résultats de recherche interne — j'utilise le robots.txt. Les deux outils sont complémentaires, mais jamais interchangeables. Ce type d'arbitrage fait partie du travail de fond que je mène dans mes missions de référencement, où chaque décision technique doit servir un objectif de visibilité précis.
Les erreurs qui bloquent tout le site
Au fil de mes audits, j'ai vu passer un certain nombre de configurations qui, en une ligne, sabotaient tout le travail de référencement d'un site. La plus redoutable reste le fameux Disallow: / appliqué à tous les robots. Cette ligne interdit purement et simplement l'exploration de l'ensemble du site. Elle apparaît souvent après une mise en ligne, car de nombreux sites en développement bloquent volontairement les robots pour éviter d'être indexés prématurément — et l'on oublie de retirer ce blocage le jour de la mise en production.
Sur WordPress, ce risque a un visage bien connu : la case « Demander aux moteurs de recherche de ne pas indexer ce site » dans les réglages de lecture. Quand elle est cochée, le CMS ajoute des consignes de blocage qui empêchent l'exploration. Je vérifie systématiquement ce réglage lorsqu'un client me signale que son nouveau site n'apparaît nulle part. C'est un contrôle que j'intègre à chaque projet de création de site internet WordPress, car cette simple case oubliée peut coûter des semaines de visibilité.
Une autre erreur fréquente consiste à bloquer les ressources dont Google a besoin pour afficher correctement vos pages. Pendant longtemps, on lisait des robots.txt qui interdisaient l'accès aux dossiers de fichiers CSS et JavaScript. Le problème, c'est que Google rend aujourd'hui vos pages comme le ferait un navigateur : s'il ne peut pas charger ces fichiers, il voit une page cassée, mal structurée, et cela peut nuire à l'évaluation de votre site, notamment sur le plan de l'expérience mobile. Je m'assure toujours que les ressources d'affichage restent accessibles aux robots.
Les erreurs de syntaxe et de placement complètent ce tableau. Un fichier robots.txt qui ne se trouve pas exactement à la racine du domaine ne sera pas lu. Un fichier accessible uniquement en sous-dossier, ou renvoyant une erreur, sera ignoré. Il faut aussi retenir que le fichier est spécifique à un protocole et à un sous-domaine : le robots.txt de blog.site.fr est distinct de celui de site.fr. Enfin, une casse mal gérée peut poser problème, car les chemins sont sensibles à la casse : /Dossier/ et /dossier/ ne désignent pas la même chose.
Comment tester et déployer son robots.txt sereinement
Une fois le fichier écrit, je ne le mets jamais en ligne sans l'avoir vérifié. La Google Search Console reste mon outil de référence pour cela : elle permet de consulter la version du robots.txt que Google a lue, de voir la date de la dernière lecture et de repérer d'éventuelles erreurs de traitement. C'est aussi là que je vérifie, page par page, si une URL donnée est autorisée ou bloquée à l'exploration, grâce à l'outil d'inspection d'URL.
Ma méthode de travail suit toujours le même ordre. Je commence par lister les zones à exclure en me demandant, pour chacune, si elle apporte une valeur en référencement. Un espace d'administration, des URL de filtres qui génèrent des doublons à l'infini, une page de remerciement après un formulaire : voilà des candidats naturels au blocage. En revanche, une page produit, un article, une page de service n'ont rien à faire dans un Disallow. Ensuite, j'écris les règles de la manière la plus simple possible, car un fichier trop complexe devient une source d'erreurs.
Je garde aussi en tête que le robots.txt est un document public : n'importe qui peut lire le vôtre en tapant son adresse. Il est donc contre-productif d'y lister des chemins sensibles que vous préféreriez garder discrets, puisque vous les exposeriez à la vue de tous. Là encore, la sécurité passe par d'autres moyens que ce fichier.
Un dernier réflexe que j'adopte systématiquement consiste à toujours déclarer l'adresse de mon sitemap XML dans le robots.txt. C'est un moyen simple et gratuit d'indiquer aux moteurs où trouver la liste complète de vos pages, ce qui accélère la découverte des nouveaux contenus. Sur un site fraîchement mis en ligne ou après une refonte, ce petit geste facilite grandement le travail des robots. Je vérifie enfin que le fichier renvoie bien un code de réponse correct : un robots.txt qui retourne une erreur serveur peut, dans certains cas, être interprété comme une interdiction temporaire d'explorer tout le site, ce qui reviendrait à se tirer une balle dans le pied sans même s'en rendre compte.
Enfin, je considère le robots.txt comme un document vivant. Un site évolue, de nouvelles sections apparaissent, d'anciennes disparaissent. Je recommande de le revoir à chaque refonte, à chaque migration et lors des audits périodiques. Cette rigueur technique est au cœur de mon approche de l'expertise SEO, où la maîtrise de l'exploration conditionne tout le reste : un site que Google explore mal ne pourra jamais être bien positionné, quelle que soit la qualité de son contenu. C'est aussi l'un des points que je détaille dans mes sessions de formation SEO, car comprendre le crawl, c'est comprendre la logique même des moteurs de recherche.
Ce qu'il faut retenir sur le robots.txt
Le fichier robots.txt est un outil simple dans sa forme mais exigeant dans son usage. Il ne s'agit pas d'un outil de sécurité, ni d'un moyen de désindexer une page, mais d'un guide d'exploration qui oriente les robots vers l'essentiel et les éloigne du superflu. Sa force réside dans la clarté : quelques lignes bien pensées suffisent à optimiser le budget de crawl d'un grand site, tandis qu'une seule ligne mal placée peut le rendre invisible. Retenez surtout la distinction fondamentale entre exploration et indexation : le robots.txt gère la première, la balise noindex gère la seconde, et confondre les deux mène droit aux ennuis. Vérifiez toujours votre fichier après une mise en ligne, surtout sur WordPress, et testez-le dans la Search Console avant de considérer le travail comme terminé.
Si vous avez un doute sur la configuration de votre fichier, si votre site peine à être exploré ou si vous soupçonnez qu'une consigne oubliée bride votre visibilité, je peux vous aider à y voir clair. N'hésitez pas à me contacter pour un accompagnement webmarketing : ensemble, nous ferons en sorte que Google explore exactement ce qui doit l'être, et rien d'autre.