Publier une page ne suffit pas à la rendre visible sur Google. Entre le moment où je mets une URL en ligne et celui où elle apparaît réellement dans les résultats de recherche, il se joue une étape décisive que beaucoup négligent : l'indexation. Tant qu'une page n'est pas indexée, elle n'existe tout simplement pas pour le moteur, quelle que soit la qualité de son contenu. En tant que consultant SEO et formateur à Arras, je vois régulièrement des sites soignés dont une partie des pages reste bloquée à la porte de l'index, parfois pendant des semaines. Dans cet article, je partage ma méthode pour faire indexer vos pages plus vite et, surtout, pour fiabiliser leur prise en compte dans la durée. Je vais volontairement rester concret : ce sont les gestes que j'applique au quotidien sur les projets que j'accompagne.
Comprendre l'indexation avant de vouloir l'accélérer
Avant de chercher à gagner du temps, il faut savoir ce que l'on cherche à accélérer. Le parcours d'une page dans Google se déroule en trois grandes phases : l'exploration (Google découvre l'URL), l'indexation (Google analyse le contenu et décide de le stocker dans son index) et le classement (Google décide à quelle position afficher la page pour une requête donnée). Ces trois étapes sont distinctes. Une page peut être explorée sans être indexée, et une page indexée peut très bien ne jamais se classer correctement. Confondre ces notions conduit souvent à traiter le mauvais problème.
L'indexation repose sur une logique simple du point de vue de Google : le moteur dispose de ressources limitées et cherche à ne conserver que des contenus qui apportent une valeur. Autrement dit, obtenir une indexation rapide ne se résume pas à envoyer un signal technique, c'est aussi convaincre le moteur que la page mérite d'être stockée. C'est pour cela que je travaille toujours sur deux fronts en parallèle : faciliter la découverte technique de la page, et renforcer les signaux qui montrent qu'elle a sa place dans l'index. Un bon travail de référencement naturel ne commence jamais par les mots-clés, mais par cette capacité du site à être exploré et compris.
Faciliter l'exploration : la base d'une prise en compte rapide
Google ne peut indexer que ce qu'il explore. La première question à se poser est donc : mes pages sont-elles réellement accessibles au robot d'exploration ? Plusieurs éléments conditionnent cette accessibilité. Le fichier robots.txt, d'abord, doit autoriser l'exploration des sections que je veux voir indexées : une directive de blocage mal placée peut interdire l'accès à des répertoires entiers sans que personne ne s'en rende compte. La balise meta robots, ensuite, doit être en « index, follow » sur les pages stratégiques, et surtout pas en « noindex », une erreur bien plus fréquente qu'on ne l'imagine, notamment après une mise en production depuis un environnement de préproduction.
La vitesse et la stabilité du serveur jouent également un rôle direct. Si mes pages répondent lentement ou renvoient des erreurs, Google réduit la fréquence de ses passages pour ne pas surcharger le site. J'accorde donc une attention particulière aux temps de réponse et aux codes HTTP renvoyés. Une architecture claire aide énormément : plus une page est proche de la page d'accueil en nombre de clics, plus elle a de chances d'être découverte et explorée rapidement. Sur les projets que je construis sous WordPress, je veille dès la création du site internet à ce que cette arborescence reste lisible, sans pages orphelines enfouies à cinq ou six niveaux de profondeur.
Un dernier point que je vérifie systématiquement : la cohérence des URL canoniques. Si plusieurs versions d'une même page coexistent (avec et sans slash final, en http et en https, avec des paramètres divers), Google peut hésiter sur la version à retenir et diluer son budget d'exploration. Une balise canonique bien posée indique clairement quelle URL fait référence, et évite que le moteur ne gaspille ses ressources sur des doublons qui, de toute façon, ne seront pas tous indexés.
Le sitemap XML : votre feuille de route pour Google
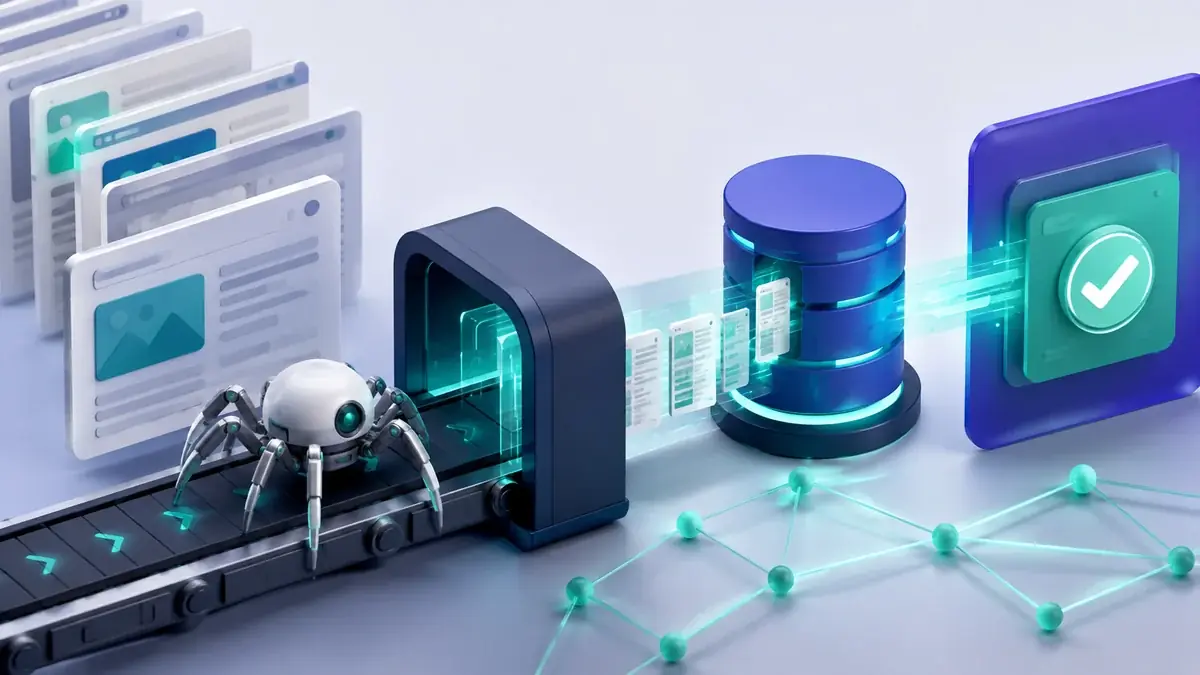
Le sitemap XML est l'outil que je considère comme incontournable pour orienter l'exploration. Il ne garantit pas l'indexation, c'est important de le dire clairement, mais il fournit à Google une liste organisée des URL que je juge importantes. C'est particulièrement utile pour les pages récentes, celles qui ne sont pas encore bien reliées au reste du site, ou pour les sites volumineux où le robot ne peut pas tout parcourir en un seul passage. Un sitemap propre agit comme une feuille de route : il dit au moteur « voici ce qui compte, commence par là ».
Pour qu'un sitemap remplisse vraiment son rôle, il doit respecter quelques principes. Je n'y place que des URL réellement indexables : des pages en 200, sans balise noindex, canoniques vers elles-mêmes. Y laisser des redirections, des erreurs 404 ou des pages bloquées envoie des signaux contradictoires et affaiblit la confiance que Google accorde au fichier. Je veille aussi à ce que le sitemap se mette à jour automatiquement lorsque je publie ou modifie une page, afin que la date de dernière modification reflète la réalité. Sur WordPress, cette génération est en général prise en charge par l'extension SEO du site, à condition de la configurer correctement.
Une fois le sitemap prêt, je le déclare dans le fichier robots.txt et je le soumets dans la Search Console. Ce double signal permet à Google de le récupérer rapidement. Pour un site qui publie régulièrement, un sitemap tenu à jour reste l'un des moyens les plus fiables de réduire le délai entre publication et indexation. C'est un travail de fond qui, bien mené, fait partie intégrante d'une stratégie d'expertise SEO cohérente sur le long terme.
Sur les sites de taille importante, je vais parfois plus loin en segmentant le sitemap en plusieurs fichiers regroupés dans un index de sitemaps : un pour les articles, un pour les pages, un pour les catégories, par exemple. Cette organisation présente un double intérêt. Elle facilite ma propre lecture, puisque la Search Console me remonte les statistiques d'indexation fichier par fichier et me montre immédiatement quel type de contenu peine à être pris en compte. Et elle aide Google à explorer le site de façon plus structurée, en distinguant clairement les différentes familles de pages. Ce niveau de finesse n'est pas indispensable pour un petit site vitrine, mais il devient un vrai atout dès que le volume d'URL se compte en centaines.
Le maillage interne, mon levier préféré pour l'indexation
Si je devais ne garder qu'un seul levier pour accélérer et fiabiliser la prise en compte des pages, ce serait le maillage interne. Les liens internes sont les chemins que suit le robot d'exploration pour aller de page en page. Une page bien maillée, c'est-à-dire pointée depuis plusieurs autres pages pertinentes du site, est découverte plus vite et bénéficie d'un signal d'importance plus fort. À l'inverse, une page orpheline, sans aucun lien entrant, ne sera trouvée que par le sitemap et restera fragile : Google la considérera souvent comme secondaire, voire ne l'indexera pas du tout.
Concrètement, dès que je publie une nouvelle page, je me pose deux questions. Depuis quelles pages existantes puis-je faire un lien vers elle ? Et vers quelles pages pertinentes cette nouvelle page peut-elle elle-même renvoyer ? Cette double logique crée un réseau de liens cohérent qui aide autant l'utilisateur que le moteur. J'utilise des ancres descriptives, c'est-à-dire des textes de lien qui décrivent réellement la page de destination, plutôt que des « cliquez ici » qui n'apportent aucune information contextuelle. Ces ancres participent à la compréhension du sujet de la page cible et renforcent le maillage sémantique.
Je profite aussi de chaque refonte ou de chaque audit pour traquer les pages orphelines, ces contenus qu'un site finit toujours par accumuler avec le temps : anciens articles, pages créées à la va-vite, contenus produits pour une campagne ponctuelle puis oubliés. Les identifier demande un peu de méthode, mais l'exercice est très rentable, car il suffit souvent de rétablir quelques liens internes pour qu'une page abandonnée depuis des mois retrouve le chemin de l'index. C'est l'une des interventions les plus rapides que je connaisse pour débloquer une indexation qui stagne.
Le maillage interne a un autre avantage précieux : il transmet de l'autorité. Une page importante et déjà bien indexée qui pointe vers une page récente lui transfère une partie de sa légitimité aux yeux de Google. C'est pourquoi je relie systématiquement mes nouveaux contenus aux pages piliers du site, celles qui reçoivent déjà du trafic et de la confiance. Cette mécanique, que j'explique en détail lors de mes formations SEO à Arras, Lille et Paris, transforme un contenu isolé en page pleinement intégrée à l'écosystème du site, ce qui change tout pour son indexation.
Search Console : demander et vérifier l'indexation
La Google Search Console est mon tableau de bord de référence pour tout ce qui touche à l'indexation. C'est là que je vérifie l'état réel de chaque page, et non pas ce que je suppose. L'outil d'inspection d'URL est le premier réflexe : je saisis l'adresse d'une page et Google me dit si elle est indexée, si elle a été explorée, et si un obstacle empêche sa prise en compte. Cet écran est une mine d'informations car il distingue clairement les différents cas de figure, ce qui évite de traiter au hasard.
Quand je publie une page importante ou que j'en modifie une de façon substantielle, j'utilise la fonction « Demander une indexation » directement depuis cet outil d'inspection. Cela place l'URL dans une file d'attente prioritaire d'exploration. Je précise tout de suite une chose essentielle pour ne pas entretenir de fausses attentes : cette demande n'oblige pas Google à indexer, et elle ne doit pas être utilisée en masse ni de façon répétée sur la même URL. C'est un coup de pouce ponctuel, pas une baguette magique. Utilisée avec discernement, elle permet néanmoins de gagner un temps précieux sur les pages stratégiques.
Le rapport « Pages » de la Search Console complète cette vision au niveau du site entier. Il liste les pages indexées et, surtout, celles qui ne le sont pas, en regroupant les URL par motif : exclue par une balise noindex, page dupliquée, explorée mais non indexée, détectée mais non explorée, et ainsi de suite. J'analyse ces regroupements régulièrement car ils révèlent des schémas. Si des dizaines de pages tombent dans la même catégorie, ce n'est pas un hasard, c'est le symptôme d'un problème structurel que je peux corriger d'un coup. Cette surveillance est pour moi la meilleure façon de piloter l'indexation dans le temps plutôt que de la subir.
Les causes fréquentes de non-indexation et leurs solutions
Lorsqu'une page refuse de s'indexer, il existe presque toujours une explication précise. Plutôt que de tâtonner, j'ai pris l'habitude de rapprocher le message affiché dans la Search Console d'une cause connue, puis d'appliquer la correction correspondante. Voici les situations que je rencontre le plus souvent sur les sites que j'audite, avec l'action que je recommande pour chacune. Ce tableau sert de grille de lecture rapide quand une URL ne veut pas apparaître dans l'index.
| Cause fréquente de non-indexation | Solution recommandée |
|---|---|
| Balise meta robots en « noindex » oubliée après une mise en production | Vérifier et remettre les pages stratégiques en « index, follow », puis redemander l'indexation |
| Page bloquée par le fichier robots.txt | Retirer la directive de blocage sur les répertoires à indexer et tester l'URL dans l'outil d'inspection |
| Page orpheline, sans aucun lien interne entrant | Créer des liens depuis des pages pertinentes et déjà indexées du site |
| Contenu jugé trop mince ou dupliqué (« explorée, non indexée ») | Enrichir le contenu, le rendre unique et lui donner un angle propre |
| Mauvaise balise canonique pointant vers une autre URL | Corriger la canonique pour qu'elle désigne la page elle-même |
| Page détectée mais non explorée (budget d'exploration limité) | Améliorer les temps de réponse serveur et renforcer le maillage vers la page |
| Erreurs serveur ou redirections en chaîne | Corriger les codes HTTP et supprimer les redirections intermédiaires inutiles |
La catégorie « explorée, actuellement non indexée » mérite une attention particulière car elle déroute beaucoup de propriétaires de sites. Elle signifie que Google a vu la page, l'a lue, mais a choisi de ne pas la stocker. Dans la grande majorité des cas, ce n'est pas un problème technique mais un problème de valeur perçue : le contenu ressemble à ce qui existe déjà ailleurs, ou n'apporte pas assez pour justifier sa présence dans l'index. La réponse n'est alors pas de forcer l'indexation, mais de retravailler le fond de la page pour qu'elle devienne réellement utile et distincte.
Mon plan d'action pour indexer plus vite et durablement
Au fil des projets, j'ai construit une routine que j'applique à chaque nouvelle page importante, et qui condense tout ce que je viens de décrire. Je commence par vérifier l'accessibilité technique : la page renvoie bien un code 200, elle n'est pas bloquée par le robots.txt, elle est en « index, follow » et sa balise canonique pointe vers elle-même. Ces contrôles prennent quelques minutes et évitent des semaines d'attente inutile. Trop de blocages d'indexation viennent d'un simple oubli de configuration, pas d'un problème de fond.
Ensuite, je m'occupe des signaux de découverte. J'ajoute la page au sitemap, je m'assure que celui-ci est bien à jour, et je tisse immédiatement des liens internes depuis des pages déjà bien positionnées. Je considère qu'une page publiée sans lien entrant est une page publiée à moitié. Enfin, j'utilise l'inspection d'URL de la Search Console pour demander l'indexation, puis je note la date afin de suivre le délai réel de prise en compte. Cette dernière étape me permet de mesurer, projet par projet, la vitesse d'indexation propre à chaque site et de repérer les éventuelles anomalies.
Une remarque de bon sens pour finir sur ce plan : la régularité de publication compte autant que chaque geste isolé. Un site qui publie fréquemment du contenu de qualité habitue Google à revenir souvent, ce qui réduit mécaniquement les délais d'indexation des pages suivantes. À l'inverse, un site figé pendant des mois voit sa fréquence d'exploration diminuer, et ses nouvelles pages mettent plus de temps à être prises en compte. L'indexation rapide n'est donc pas seulement une affaire de réglages ponctuels, c'est aussi la conséquence d'une dynamique éditoriale entretenue dans la durée.
Ce qu'il faut retenir sur l'indexation de vos pages
Faire indexer ses pages plus vite ne relève d'aucune astuce miracle, mais d'une succession de gestes rigoureux qui, mis bout à bout, font une réelle différence. Il faut d'abord garantir l'accessibilité technique de la page, puis orienter l'exploration grâce au sitemap, renforcer sa découverte par un maillage interne solide, et enfin vérifier concrètement son état dans la Search Console. Quand une page résiste, la bonne démarche consiste à identifier la cause précise plutôt qu'à multiplier les demandes d'indexation, souvent inutiles. Et derrière chaque page bloquée depuis longtemps se cache presque toujours soit un problème de configuration facile à corriger, soit un contenu à retravailler pour qu'il gagne sa place dans l'index.
Si vous constatez que plusieurs de vos pages restent invisibles sur Google malgré vos efforts, il y a fort à parier qu'un diagnostic méthodique permettrait de débloquer la situation rapidement. C'est précisément ce type d'accompagnement que je propose depuis Arras pour les entreprises qui veulent fiabiliser leur présence en ligne. N'hésitez pas à me contacter pour échanger sur votre projet : nous ferons le point ensemble sur l'état d'indexation de votre site et sur les leviers concrets à activer pour que vos pages soient enfin prises en compte comme elles le méritent.