Quand j'accompagne un site qui grandit, une question revient sans cesse : pourquoi certaines pages mettent-elles des semaines à apparaître dans Google, alors que d'autres, sans intérêt, sont explorées en boucle ? La réponse tient souvent en deux mots : le crawl budget. Ce budget d'exploration correspond à la quantité de ressources que Google accepte de consacrer à parcourir votre site sur une période donnée. Il n'est pas infini. Sur un petit site vitrine, il ne pose aucun problème. Mais dès que l'on manipule des milliers d'URL, un e-commerce avec des filtres, un blog volumineux ou un annuaire, la façon dont les robots dépensent ce budget devient un véritable levier de référencement. Dans cet article, je vous explique comment j'aide Google à concentrer son exploration sur ce qui compte réellement, et comment j'élimine le gaspillage d'exploration qui plombe tant de projets.
Le crawl budget, ou comment Google répartit son temps d'exploration
Le crawl budget n'est pas une valeur affichée quelque part dans un tableau de bord. C'est une notion qui combine deux mécanismes complémentaires. Le premier, Google l'appelle la limite de capacité d'exploration : c'est le nombre de requêtes simultanées que Googlebot s'autorise à envoyer à votre serveur sans le fatiguer. Si votre hébergement répond vite et sans erreur, cette limite monte. S'il rame ou renvoie des erreurs, Google lève le pied pour ne pas dégrader l'expérience de vos visiteurs. Le second mécanisme, c'est la demande d'exploration : Google explore davantage les pages qu'il juge populaires ou fraîches, et délaisse celles qui semblent figées ou sans valeur.
Autrement dit, votre budget d'exploration dépend à la fois de la santé technique de votre serveur et de l'intérêt que Google porte à vos contenus. Ces deux dimensions se travaillent. Un site rapide, stable, bien structuré et régulièrement mis à jour envoie un signal clair : « il vaut la peine d'être exploré souvent ». Un site lent, truffé de pages orphelines ou dupliquées, dilue son capital d'exploration sur des URL qui n'apporteront jamais rien. Mon rôle de consultant consiste précisément à rééquilibrer cette répartition en faveur des pages stratégiques.
Je précise aussi un point qui rassure souvent mes interlocuteurs : Google n'a aucun intérêt à sanctionner un site en lui coupant l'exploration. Sa logique est purement pragmatique. Il veut découvrir et rafraîchir le maximum de contenus utiles avec le minimum de ressources gaspillées, chez vous comme sur les millions d'autres sites qu'il parcourt chaque jour. Quand je parle d'optimiser le budget d'exploration, je ne cherche donc pas à ruser avec l'algorithme : je cherche à rendre le site plus lisible et plus économe à parcourir, ce qui coïncide exactement avec ce que Google recherche. Cet alignement d'intérêts est ce qui rend le travail durable, contrairement aux astuces qui vieillissent mal.
Reconnaître le gaspillage d'exploration sur son site
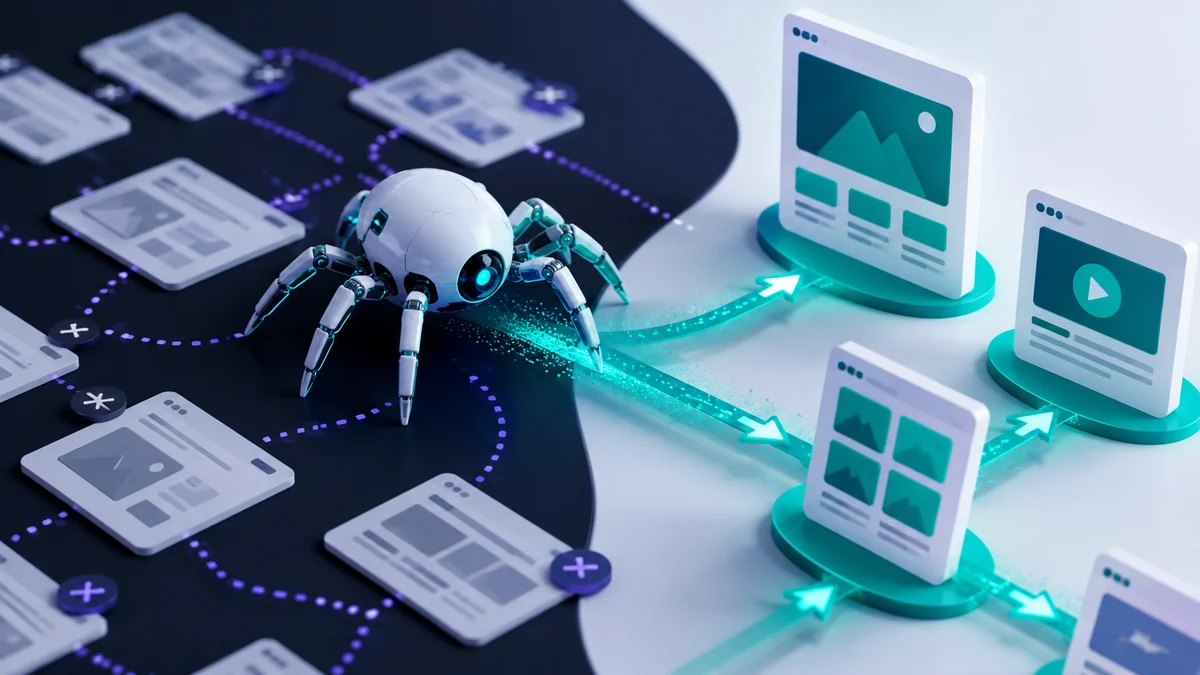
Le premier réflexe, avant de vouloir « augmenter » son budget, c'est d'identifier où il fuit. Car dans la grande majorité des cas, le problème n'est pas que Google explore trop peu : c'est qu'il explore mal. J'ai vu des sites où plus de la moitié des requêtes de Googlebot tombaient sur des pages inutiles : paramètres de tri, sessions, pages de résultats internes, versions imprimables, variantes de filtres qui génèrent des combinaisons infinies. Chaque URL parasite explorée, c'est une URL utile qui attendra plus longtemps.
Voici les grandes familles de gaspillage d'exploration que je rencontre le plus souvent lors de mes audits, avec leur origine et la manière dont je les traite. C'est rarement un seul problème qui domine, mais l'accumulation de ces fuites qui finit par étouffer l'exploration des contenus à valeur.
| Type de page explorée à tort | Origine fréquente | Traitement que je privilégie |
|---|---|---|
| URL à paramètres (tri, filtres, sessions) | Navigation à facettes, e-commerce | Blocage ciblé, balise canonique, gestion des liens |
| Pages de recherche interne | Moteur de recherche du site indexé | Blocage dans le fichier robots.txt |
| Contenus dupliqués ou quasi identiques | Fiches similaires, pagination mal gérée | Consolidation, balise canonique |
| Pages en erreur (404, 5xx) ou redirections en chaîne | Migrations, liens internes obsolètes | Correction des liens, nettoyage des chaînes |
| Pages de faible valeur (tags vides, archives) | CMS générant des taxonomies à outrance | Désindexation, suppression ou enrichissement |
Ce tableau résume ce que je cherche à débusquer, mais chaque site a sa propre signature. Un blog éditorial ne gaspille pas son budget d'exploration de la même façon qu'une marketplace. C'est pourquoi je ne travaille jamais à partir de recettes toutes faites : je pars toujours des données réelles du site. Si vous souhaitez un regard extérieur sur votre architecture, mon métier de consultant en référencement naturel consiste justement à cartographier ces fuites avant de proposer un plan d'action.
Les logs serveur, ma source de vérité pour l'exploration
On peut discuter du crawl budget pendant des heures en théorie, mais la seule manière de savoir vraiment ce que fait Google sur votre site, c'est de lire ses traces. Ces traces, ce sont les logs serveur. Chaque fois que Googlebot demande une page, votre serveur consigne cette visite : l'URL demandée, la date, le code de réponse, l'agent utilisé. En analysant ces fichiers sur plusieurs semaines, j'obtiens une photographie fidèle et non déclarative du comportement des robots.
L'analyse de logs répond à des questions que ni Search Console ni aucun outil de crawl ne peuvent trancher seuls. Quelles pages Googlebot visite-t-il le plus souvent ? Combien de ses requêtes tombent sur des redirections ou des erreurs ? Explore-t-il les rubriques que vous jugez prioritaires, ou passe-t-il son temps dans des recoins oubliés ? Découvre-t-il vos nouveaux contenus rapidement, ou avec des jours de retard ? Ces réponses orientent tout le reste de mon travail.
Je croise systématiquement ces logs avec la liste des URL réellement importantes pour l'activité. Quand je constate que Googlebot concentre l'essentiel de ses visites sur des pages à paramètres sans valeur, je sais où agir en priorité. Cette approche par la donnée, je la considère comme le socle d'une stratégie de référencement durable : on ne devine pas, on mesure, puis on décide. C'est aussi ce qui me permet d'expliquer clairement à mes clients pourquoi telle page tarde à être indexée, sans me réfugier derrière des explications vagues.
Une précision utile : il ne faut pas confondre un pic ponctuel d'exploration avec un problème. Après une mise en ligne massive ou une migration, il est normal que Googlebot s'active davantage pendant quelques jours. Ce qui doit alerter, c'est la tendance dans la durée : un budget d'exploration qui s'épuise semaine après semaine sur les mêmes recoins sans valeur, des contenus neufs découverts avec un retard chronique, ou un taux d'erreurs qui grimpe. C'est en observant ces signaux sur plusieurs semaines, et non sur un instantané, que l'analyse de logs révèle sa vraie puissance. Sans cette perspective temporelle, on risque de sur-réagir à un simple soubresaut technique.
Robots.txt, balises et niveau de blocage : à chaque outil son rôle
Une fois les fuites identifiées, encore faut-il choisir le bon instrument pour les colmater. C'est là que beaucoup de sites se trompent, en confondant des outils qui n'agissent pas au même niveau. Je prends toujours le temps d'expliquer cette distinction, car elle conditionne l'efficacité de toute optimisation du budget d'exploration.
Le fichier robots.txt agit en amont : il dit à Googlebot « ne va pas explorer cette zone ». C'est l'outil idéal pour empêcher le robot de dépenser son budget sur des répertoires entiers de pages inutiles, comme les résultats de recherche interne ou certains scripts. Mais attention : bloquer une URL dans le robots.txt n'empêche pas forcément son indexation si des liens pointent vers elle. Le robots.txt gère l'exploration, pas l'indexation.
La balise meta noindex, elle, agit après l'exploration : elle laisse Google visiter la page mais lui demande de ne pas la faire apparaître dans les résultats. Elle est parfaite pour désindexer une page de faible valeur tout en laissant les robots suivre ses liens. La balise canonique, enfin, ne bloque rien : elle indique quelle version d'un contenu dupliqué doit être considérée comme la référence. Utiliser ces trois leviers à bon escient, c'est éviter la contradiction classique où l'on bloque dans le robots.txt une page que l'on voulait désindexer, empêchant Google de lire le noindex qu'elle contient.
Il faut aussi garder en tête l'effet du maillage interne sur cette mécanique. Une page que vous jugez secondaire mais vers laquelle pointent des dizaines de liens internes continuera d'attirer les robots, quelles que soient vos intentions. À l'inverse, une page importante mais faiblement liée depuis le reste du site sera explorée avec parcimonie. Avant de multiplier les blocages, je regarde donc toujours d'où viennent les liens : bien souvent, la solution la plus propre n'est pas d'interdire une URL, mais de cesser de la mettre en avant dans la navigation. Réduire les liens vers l'accessoire réoriente naturellement le budget d'exploration vers l'essentiel, sans recourir à des directives qui alourdissent la maintenance.
La pagination, un cas d'école du gaspillage d'exploration
S'il y a bien un sujet qui concentre les erreurs, c'est la pagination. Les listes de produits, les archives de blog, les catégories volumineuses se déclinent en dizaines, parfois centaines de pages numérotées. Chacune est une URL que Googlebot peut explorer. Mal gérée, la pagination dévore une part considérable du crawl budget pour un bénéfice quasi nul, puisque les pages profondes n'ont souvent aucune valeur de positionnement propre.
Ma logique est simple : les pages paginées doivent rester explorables, car elles constituent le chemin par lequel Google découvre les contenus profonds, mais elles ne doivent pas concurrencer la première page ni gonfler l'index. Je veille donc à ce que chaque page paginée reste accessible via des liens internes clairs, avec des URL propres et stables, sans paramètres superflus. J'évite les mécanismes de chargement infini qui masquent les liens aux robots et rendent les contenus profonds invisibles.
Un point que je répète souvent en formation : la meilleure façon de réduire la pression de la pagination sur le budget d'exploration, ce n'est pas toujours de bricoler les balises, c'est de repenser l'architecture. Des catégories bien découpées, un maillage interne qui remonte les contenus importants, des pages de référence solides : voilà ce qui raccourcit les chemins d'exploration. J'aborde en détail ces arbitrages avec ceux que je forme, car comprendre la mécanique vaut mieux que d'appliquer des règles à l'aveugle. C'est tout l'esprit de mes formations SEO en présentiel et à distance.
Aider Google à explorer l'essentiel : ma méthode concrète
Optimiser le budget d'exploration n'est pas une opération unique, c'est une démarche progressive. Voici la façon dont je procède, dans l'ordre, pour transformer un site qui se disperse en un site qui guide Google vers l'essentiel.
Je commence par cartographier l'existant : crawl complet du site, analyse des logs serveur, croisement avec les données de Search Console et la liste des pages stratégiques. Cette phase de diagnostic est non négociable, car elle évite d'agir sur des suppositions. Vient ensuite le nettoyage des fuites : traitement des pages à paramètres, correction des erreurs et des redirections en chaîne, désindexation des contenus sans valeur, révision du robots.txt. À ce stade, j'ai déjà libéré une part significative du budget.
Je travaille alors la structure et le maillage interne : je raccourcis les chemins vers les pages importantes, je consolide les contenus dupliqués, je renforce les liens vers les rubriques prioritaires. Un contenu accessible en deux clics depuis l'accueil est exploré bien plus souvent qu'une page enfouie à cinq niveaux de profondeur. Enfin, je soigne la santé technique : temps de réponse serveur, stabilité, plan de site XML propre et à jour ne listant que des URL canoniques et indexables. Chaque signal de fiabilité incite Google à explorer davantage.
Cette méthode, je l'adapte selon la taille et le type de site. Un site local avec quelques dizaines de pages n'a pas les mêmes priorités qu'une plateforme à fort volume. Autour d'Arras, de Lille et dans les Hauts-de-France, j'accompagne des structures très différentes, et cette proximité me permet d'échanger de vive voix sur les enjeux propres à chaque projet. Si vous êtes dans la région, sachez que je propose un accompagnement de consultant SEO près de Lille pensé pour ces réalités de terrain.
J'insiste enfin sur un ordre de priorité qui évite bien des déceptions. On est souvent tenté de commencer par les réglages les plus techniques, parce qu'ils donnent l'impression d'agir. Or, dans mon expérience, ce sont les gestes les plus simples qui libèrent le plus de budget d'exploration : supprimer les pages sans valeur, corriger les erreurs, resserrer le maillage. Les ajustements fins de robots.txt et de balises ne viennent qu'ensuite, pour peaufiner. Traiter les choses dans cet ordre garantit que chaque effort produit un résultat visible, plutôt que de se perdre dans des micro-optimisations dont l'impact reste marginal tant que les grosses fuites ne sont pas colmatées.
Faut-il vraiment se soucier du crawl budget ?
Je termine par une mise en garde, car le sujet est parfois surinvesti. Si vous gérez un site de quelques dizaines ou centaines de pages, propre et bien maillé, le crawl budget n'est pas votre priorité : Google explorera sans peine l'ensemble de vos contenus. Se lancer dans des optimisations complexes serait alors une perte de temps par rapport à un travail sur le contenu ou sur l'expérience utilisateur.
Le budget d'exploration devient un vrai sujet à partir du moment où le volume d'URL explose, où l'on observe des délais d'indexation anormaux, où les logs révèlent que Googlebot passe l'essentiel de son temps sur des pages inutiles. C'est là que le travail que je viens de décrire prend tout son sens et se traduit par des gains concrets : découverte plus rapide des nouveaux contenus, meilleure fraîcheur dans l'index, exploration recentrée sur ce qui génère du trafic et des conversions.
L'idée à retenir est simple : on ne cherche pas à forcer Google à explorer plus, on l'aide à explorer mieux. Guider les robots vers l'essentiel, c'est leur épargner tout ce qui ne mérite pas leur attention. Et ce travail de clarification profite à tout le reste de votre référencement, car un site lisible pour les moteurs l'est aussi pour vos visiteurs.
Passons à l'action sur votre site
Si vous soupçonnez que Google gaspille son budget d'exploration sur votre site, ou si vos nouvelles pages mettent trop longtemps à être indexées, il y a probablement des fuites à colmater et une architecture à clarifier. Plutôt que de rester dans l'incertitude, faisons le point ensemble à partir de vos données réelles : logs, structure, comportement de Googlebot. Je pourrai vous dire concrètement où agir en priorité. Contactez-moi pour échanger sur votre projet et donner à vos pages importantes la place qu'elles méritent dans l'exploration de Google.