Quand j'audite un site, je tombe presque systématiquement sur du contenu dupliqué. Rarement du plagiat volontaire, d'ailleurs : le plus souvent, ce sont des doublons involontaires générés par le CMS, des paramètres d'URL, une pagination mal gérée ou une fiche produit recopiée depuis un fournisseur. Le problème, c'est que ces répétitions passent inaperçues à l'œil nu tout en diluant vos signaux SEO et en compliquant le travail des moteurs de recherche. Dans cet article, je vous propose de démystifier le sujet : ce qu'est réellement un doublon, pourquoi il pénalise votre référencement, comment le détecter méthodiquement et surtout comment le régler avec les bons outils techniques. Mon objectif est que vous repartiez avec une méthode applicable, sans jargon inutile et sans promesse magique.
Comprendre ce qu'est vraiment le contenu dupliqué
Commençons par poser une définition claire. Le contenu dupliqué désigne un bloc de texte identique ou très fortement similaire accessible depuis plusieurs adresses, que ce soit sur votre propre site ou sur des sites différents. Google ne parle pas de « contenu identique au mot près » uniquement : deux pages qui reprennent l'essentiel du même paragraphe, avec quelques variations mineures, peuvent être considérées comme substantiellement similaires. La nuance est importante, car beaucoup de propriétaires de sites pensent être à l'abri parce qu'ils ont changé trois mots dans une description.
Il faut aussi tordre le cou à une idée reçue tenace : il n'existe pas, dans la très grande majorité des cas, de « pénalité pour contenu dupliqué » au sens d'une sanction manuelle. Ce que fait Google, c'est plutôt choisir une version parmi les doublons qu'il considère comme la plus pertinente, et reléguer les autres. Le vrai risque n'est donc pas la sanction spectaculaire, mais la dilution : votre autorité, vos liens et votre budget d'exploration se répartissent sur plusieurs URL au lieu de se concentrer sur une seule. Résultat, la page que vous vouliez positionner n'est pas toujours celle que le moteur retient.
Je distingue généralement deux grandes familles. Le duplicata interne concerne les répétitions au sein d'un même domaine : c'est de loin le cas le plus fréquent et le plus facile à corriger. Le duplicata externe concerne les textes partagés entre plusieurs domaines, par exemple une fiche produit reprise à l'identique par des dizaines de revendeurs, ou un article republié ailleurs. Les deux appellent des réponses différentes, et c'est pour cela qu'il faut d'abord savoir dans quelle catégorie on se trouve.
Les sources de doublons internes que je rencontre le plus souvent
Sur les sites que j'accompagne, les doublons internes viennent presque toujours des mêmes mécanismes techniques. Le premier est celui des paramètres d'URL. Un filtre de tri, un identifiant de session, une variable de suivi comme utm_source ou un paramètre de pagination créent des adresses différentes qui affichent pourtant le même contenu. Techniquement, exemple.fr/chaussures et exemple.fr/chaussures?couleur=rouge&tri=prix sont deux URL distinctes aux yeux de Google, même si la page rendue est quasi identique.
Le deuxième mécanisme concerne les variantes d'affichage de la même page. Une version avec et sans slash final, une version HTTP et une version HTTPS, une version avec et sans www, une page d'accueil accessible à la fois via / et via /index.php : autant de portes d'entrée vers un contenu unique. Sans redirection ni canonique, le moteur peut indexer plusieurs de ces variantes et hésiter sur celle à retenir.
Le troisième mécanisme, très répandu sur les CMS, tient aux pages générées automatiquement. Les archives par date, par auteur, par étiquette, les flux d'impression, les résultats de recherche interne ou les fiches déclinées par taille et par couleur produisent des blocs de texte redondants. Sur WordPress, par exemple, une même publication peut se retrouver sur la page d'accueil, dans une archive de catégorie, dans une archive de balise et dans son URL propre. C'est un point que j'examine systématiquement lors d'une création de site internet sous WordPress, car la structure choisie au départ détermine la quantité de doublons que vous devrez gérer ensuite.
Enfin, il y a les cas plus insidieux : un texte de présentation identique répété sur plusieurs pages de catégories, une description de service copiée-collée d'une ville à l'autre pour du référencement local, ou un pied de page très riche en contenu qui finit par représenter une part importante du texte de chaque page. Ces situations ne sont pas toujours pénalisantes, mais elles affaiblissent la singularité de vos pages.
Les doublons externes : syndication, plagiat et fiches fournisseurs
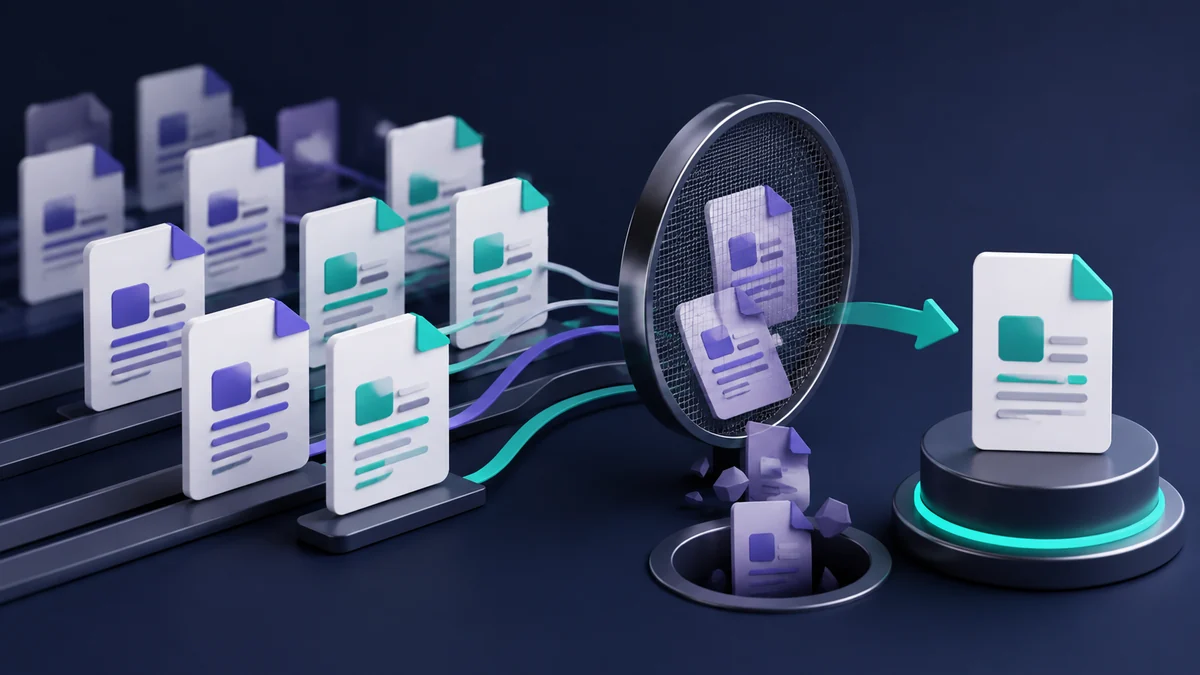
Passons à l'extérieur de votre domaine. Le cas le plus courant est celui des fiches produits fournisseurs. Quand vous vendez des articles de marque, le fabricant vous transmet souvent une description toute faite que des centaines de sites e-commerce utilisent à l'identique. Google se retrouve alors face à des pages jumelles et privilégie généralement le site le plus établi, le plus rapide ou le plus fiable à ses yeux. Si vous êtes un revendeur récent, vous partez avec un handicap que seul un travail de réécriture peut compenser.
Vient ensuite la syndication de contenu, c'est-à-dire la republication volontaire d'un article sur d'autres plateformes pour gagner en visibilité. La démarche est parfaitement légitime, mais elle doit être encadrée. Sans balisage adapté, la version republiée sur un site à forte autorité peut se positionner à la place de votre original, et vous vous faites en quelque sorte concurrence à vous-même. La solution passe par une canonique pointant vers votre page d'origine, ou au minimum par un lien de retour clair.
Le dernier cas est le plagiat pur et simple, quand un tiers copie vos textes sans autorisation. C'est frustrant, mais rassurez-vous : Google est généralement capable d'identifier la source originale grâce à la date de découverte et à l'autorité du domaine. Si un copieur venait malgré tout à vous doubler dans les résultats, il existe des recours, notamment la demande de retrait pour atteinte au droit d'auteur. Dans la pratique, je conseille surtout de renforcer sa propre légitimité plutôt que de courir après chaque copie.
Détecter les doublons : ma méthode pas à pas
On ne corrige bien que ce qu'on a correctement mesuré. Ma première étape est toujours la Search Console. Le rapport d'indexation des pages y signale les cas « Page en double sans URL canonique sélectionnée par l'utilisateur » ou « URL en double, Google a choisi une page canonique différente ». Ces messages sont de véritables mines d'or : ils vous disent noir sur blanc que le moteur a repéré des jumelles et laquelle il a retenue.
Ma deuxième étape consiste à lancer un crawl complet du site avec un outil d'exploration. En simulant le passage d'un robot, on récupère pour chaque page son titre, sa méta-description, sa balise canonique et une empreinte de son contenu. Il devient alors facile de trier par titres identiques ou par contenus similaires pour faire remonter les groupes de doublons. C'est souvent à ce moment-là qu'on découvre l'ampleur réelle du phénomène, bien au-delà de ce que l'on imaginait.
Ma troisième étape est plus artisanale mais redoutablement efficace : les recherches ciblées dans Google. En cherchant une phrase exacte de votre page entre guillemets, vous voyez immédiatement qui d'autre l'utilise, à l'intérieur comme à l'extérieur de votre site. La commande site:votredomaine.fr combinée à un extrait de texte permet aussi de repérer les répétitions internes. C'est gratuit, rapide, et cela donne une lecture concrète de la situation.
Voici un tableau récapitulatif des principaux symptômes, de leurs causes probables et des corrections que j'applique le plus souvent. Il ne remplace pas un audit personnalisé, mais il vous donne une grille de lecture pour prioriser vos actions.
| Symptôme observé | Cause probable | Correction recommandée |
|---|---|---|
| Même contenu sur plusieurs URL avec paramètres | Filtres, tri, suivi (utm), sessions | Balise canonique vers l'URL propre |
| Versions avec et sans www, HTTP et HTTPS | Absence de redirection de domaine | Redirection 301 vers la version unique |
| Fiches produits identiques à celles de concurrents | Description fournisseur reprise telle quelle | Réécriture originale et enrichie |
| Pagination indexée en double | Pages 2, 3, 4... traitées comme autonomes | Canonique auto-référente et maillage cohérent |
| Article republié ailleurs mieux positionné | Syndication sans balisage | Canonique croisée vers l'original |
| Archives d'étiquettes et de dates indexées | Réglages CMS par défaut trop permissifs | Désindexation ciblée (noindex) |
La balise canonique, mon outil de prédilection
Si je ne devais retenir qu'un seul levier, ce serait la balise canonique. Placée dans l'en-tête d'une page, elle indique aux moteurs quelle est l'adresse de référence à considérer comme l'originale. Concrètement, toutes les variantes d'une même page pointent vers une seule URL canonique, et Google concentre alors ses signaux sur celle-ci. C'est la réponse idéale pour les paramètres d'URL et les variantes d'affichage, car elle laisse les pages accessibles aux visiteurs tout en clarifiant la situation pour les robots.
Quelques principes que j'applique rigoureusement. D'abord, la canonique doit toujours pointer vers une URL valide, indexable et cohérente : il est contre-productif de désigner comme référence une page bloquée ou redirigée. Ensuite, chaque page doit être auto-référente par défaut, c'est-à-dire pointer vers elle-même tant qu'aucun doublon plus légitime n'existe. Enfin, la canonique est un signal, pas un ordre absolu : Google peut décider de l'ignorer s'il juge qu'une autre version est plus pertinente. Il faut donc l'accompagner d'une cohérence globale, dans le maillage interne comme dans le plan de site.
Attention à ne pas confondre la canonique avec la redirection. La redirection 301 supprime purement et simplement l'accès à l'ancienne adresse en envoyant le visiteur et le robot vers la nouvelle : je l'utilise pour les migrations, les changements de domaine, le passage en HTTPS ou l'unification www. La canonique, elle, conserve l'accès aux deux versions : je la réserve aux cas où les deux URL doivent rester consultables. Choisir le bon outil selon le contexte fait partie des réflexes que je transmets en formation web et SEO à Arras et dans les Hauts-de-France, car une redirection posée là où il fallait une canonique peut casser des fonctionnalités du site.
Gérer la pagination et les paramètres sans se tromper
La pagination mérite un traitement particulier, car elle est souvent mal comprise. Historiquement, on utilisait des balises rel=next et rel=prev pour lier les pages d'une série, mais Google a annoncé ne plus s'en servir. Aujourd'hui, ma recommandation est simple : chaque page paginée doit avoir une canonique auto-référente, et non pointer vers la première page. Pourquoi ? Parce que les pages 2, 3 et suivantes contiennent des produits ou des articles différents ; les traiter comme des doublons de la page 1 reviendrait à priver ces contenus d'indexation.
Ce qu'il faut vraiment surveiller sur la pagination, c'est la cohérence du maillage et l'unicité des titres. Une bonne pratique consiste à distinguer les titres et méta-descriptions des pages paginées, par exemple en ajoutant la mention de la page dans le titre, pour éviter que Google ne les perçoive comme identiques. L'essentiel est que chaque URL paginée offre une valeur propre et reste accessible depuis un système de navigation clair.
Du côté des paramètres d'URL, plusieurs approches se combinent. La canonique reste ma première ligne de défense pour ramener les variantes vers l'URL propre. Le fichier robots.txt peut, dans certains cas, empêcher l'exploration de motifs de paramètres inutiles, mais je l'utilise avec prudence car bloquer l'exploration n'empêche pas toujours l'indexation. Enfin, une bonne architecture de site limite en amont la prolifération de ces paramètres. Ces arbitrages techniques sont au cœur d'une prestation d'accompagnement SEO expert, où l'on décide au cas par cas de la stratégie la plus sûre selon la taille et la nature du site.
Réécrire, consolider ou désindexer : traiter le contenu à la source
Toutes les solutions ne sont pas techniques. Quand le doublon vient du contenu lui-même, la meilleure réponse est souvent éditoriale. Pour les fiches produits fournisseurs, je recommande une réécriture originale : ajoutez votre propre angle, des conseils d'usage, des retours d'expérience, des informations complémentaires que le fabricant ne fournit pas. Vous ne vous contentez alors pas d'éviter le doublon, vous créez de la valeur qui vous différencie réellement de vos concurrents.
Quand plusieurs pages de votre site traitent du même sujet de façon trop proche, la consolidation est souvent la meilleure voie. Plutôt que de garder trois articles moyens qui se cannibalisent, je fusionne le meilleur de chacun en une page de référence solide, puis je redirige les anciennes URL vers celle-ci. Cette opération concentre l'autorité, simplifie l'expérience du visiteur et clarifie le message que vous envoyez aux moteurs. C'est une démarche que j'intègre régulièrement dans une stratégie globale de référencement naturel, car elle renforce à la fois la lisibilité et la performance.
Enfin, il y a les pages qui n'ont tout simplement pas vocation à être indexées : résultats de recherche interne, archives d'étiquettes redondantes, versions imprimables. Pour celles-là, la balise noindex est l'outil adapté. Elle laisse la page accessible aux visiteurs mais demande aux moteurs de ne pas l'inclure dans l'index. J'insiste sur un point : une page en noindex doit rester explorable pour que la directive soit lue, donc il ne faut pas la bloquer simultanément dans le robots.txt, sous peine que l'instruction ne soit jamais prise en compte.
Éviter que le contenu dupliqué ne revienne
Régler les doublons une fois ne suffit pas ; encore faut-il empêcher qu'ils ne réapparaissent. Ma recommandation est d'inscrire quelques réflexes durables dans votre routine. D'abord, vérifier la canonique à chaque publication ou modification de gabarit, car une mise à jour du thème ou d'une extension peut réintroduire des variantes. Ensuite, surveiller régulièrement le rapport d'indexation de la Search Console pour détecter tout nouveau signalement de page en double avant qu'il ne s'installe.
Je conseille aussi de garder une discipline éditoriale : avant de créer une nouvelle page, demandez-vous si elle apporte un contenu vraiment distinct de l'existant, ou si elle risque de cannibaliser une page déjà en place. Cette question simple évite bien des chevauchements. Enfin, à chaque évolution majeure du site, refaites un crawl de contrôle : c'est la façon la plus fiable de mesurer l'impact réel de vos changements et de confirmer que les doublons ont bien disparu.
Un dernier mot sur les priorités. Toutes les répétitions ne se valent pas. Un pied de page dupliqué ou une poignée d'archives secondaires n'ont pas le même poids qu'une centaine de fiches produits jumelles ou qu'une pagination entièrement mal indexée. Concentrez vos efforts là où le volume et l'enjeu commercial sont les plus élevés, et traitez le reste progressivement. C'est cette hiérarchisation qui transforme un audit en véritable gain de visibilité.
Conclusion
Le contenu dupliqué n'est ni une fatalité ni un motif de panique. C'est un problème technique et éditorial qui se diagnostique avec méthode et se corrige avec des outils bien connus : la balise canonique pour clarifier les variantes, la redirection 301 pour unifier les versions, le noindex pour écarter les pages sans intérêt, et la réécriture pour donner à chaque contenu sa singularité. L'enjeu n'est pas d'obéir à une règle abstraite, mais de concentrer vos signaux SEO sur les pages qui comptent vraiment pour votre activité. Si vous prenez le sujet à bras-le-corps, vous récupérez du budget d'exploration, vous renforcez vos pages stratégiques et vous facilitez le travail des moteurs comme celui de vos visiteurs. Si vous avez un doute sur l'ampleur des doublons présents sur votre site, ou si vous souhaitez un plan d'action clair et priorisé, je vous invite à me contacter pour un accompagnement webmarketing personnalisé. J'analyserai votre situation et je vous proposerai les corrections les plus adaptées à vos objectifs.