Quand un client me demande pourquoi certaines de ses pages ne remontent jamais dans Google malgré un contenu de qualité, je commence presque toujours par le même geste : je lui demande ses fichiers de logs serveur. C'est souvent une découverte pour lui. On parle beaucoup de mots-clés, de netlinking ou de balises title, mais on oublie une évidence : avant de positionner une page, Google doit d'abord venir la lire. L'analyse de logs est justement la seule méthode qui montre, sans interprétation ni supposition, ce que les robots des moteurs de recherche font vraiment sur un site. Dans cet article, je vous explique comment je m'en sers au quotidien pour comprendre le comportement de Googlebot, repérer les gaspillages et remettre l'exploration au service des pages qui comptent.
L'analyse de logs, la boîte noire de votre référencement
Chaque fois qu'un visiteur ou un robot demande une page à votre serveur, celui-ci consigne l'événement dans un fichier journal. Ce fichier, c'est le log. Il contient une ligne par requête, avec des informations brutes et non négociables : l'adresse IP qui a fait la demande, la date et l'heure précises, l'URL appelée, le code de réponse HTTP renvoyé, le fameux user-agent qui identifie le demandeur, et parfois la taille de la réponse ou le temps de traitement. Là où un outil de crawl simule le passage d'un robot, le log enregistre la réalité : ce que Googlebot a réellement demandé, à quelle heure et avec quel résultat.
C'est cette fiabilité qui fait toute la valeur de l'exercice. Un rapport Search Console vous donne une vision agrégée et différée. Un crawler comme Screaming Frog vous montre ce qu'un robot pourrait explorer. Le log, lui, vous dit ce qui s'est effectivement passé. Quand je forme des équipes marketing, j'aime résumer les choses ainsi : le log est la boîte noire de votre site. Personne ne prend le temps de l'ouvrir tant que tout va bien, mais dès qu'un problème de visibilité apparaît, c'est la première chose à consulter.
Distinguer le vrai Googlebot du bruit
Première précaution avant toute analyse : tous les user-agents qui se présentent comme Googlebot ne le sont pas. De nombreux robots malveillants ou aspirateurs de contenu usurpent cette identité pour passer inaperçus. Se contenter de filtrer sur la chaîne « Googlebot » dans le user-agent fausse donc l'ensemble des conclusions. La méthode fiable consiste à vérifier l'adresse IP par une résolution DNS inversée : on demande à quel nom de domaine correspond l'IP, puis on vérifie que ce nom appartient bien à Google, avant de confirmer par une résolution directe. Google documente publiquement cette procédure et met à disposition la liste de ses plages d'adresses.
Une fois ce tri effectué, on obtient un jeu de données propre : uniquement les visites des robots authentiques. On peut alors séparer les différents agents, car Google n'explore pas avec un seul robot. Il existe notamment un robot pour ordinateur, un robot pour smartphone, et des agents dédiés aux images ou à d'autres ressources. Depuis le passage à l'index mobile-first, c'est le robot mobile qui domine largement l'exploration de la plupart des sites. Vérifier cette répartition est un bon point de départ : si votre site est encore majoritairement crawlé par l'agent desktop, cela mérite qu'on s'y intéresse.
Le budget de crawl : une ressource limitée
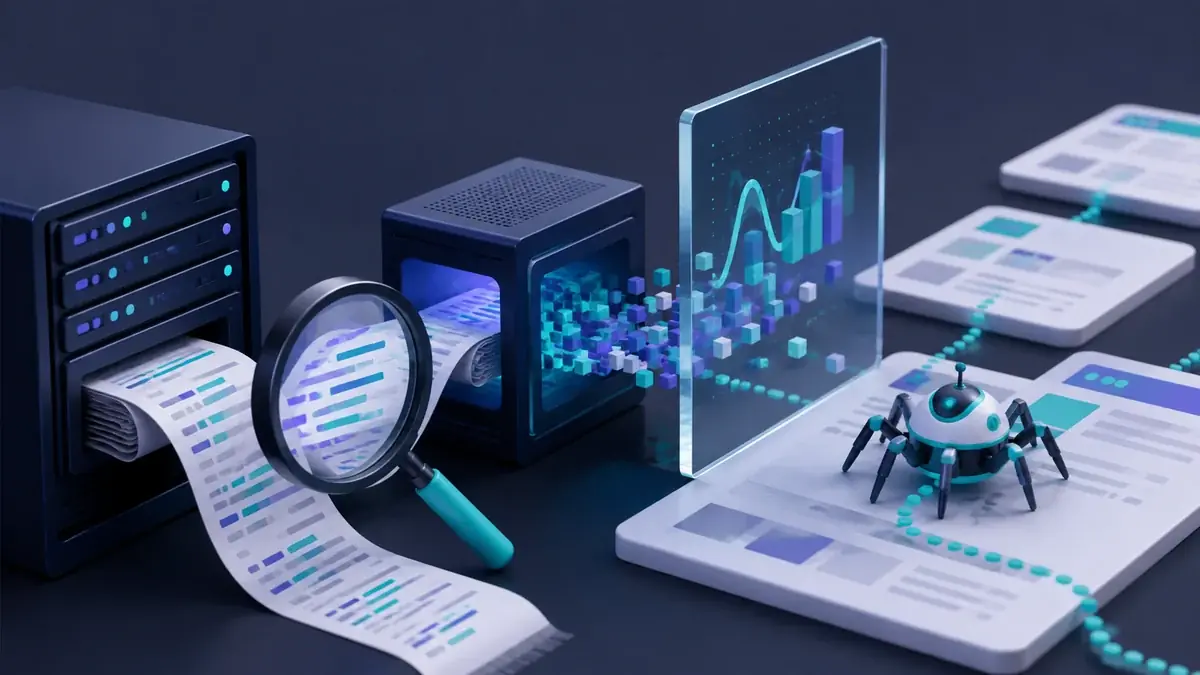
Google ne dispose pas d'un temps infini pour explorer votre site. Chaque domaine se voit accorder ce que l'on appelle un budget de crawl, c'est-à-dire un volume de requêtes que le moteur accepte de consacrer à votre site sur une période donnée. Ce budget dépend de deux grandes composantes. La première est la capacité de crawl : Google surveille le temps de réponse de votre serveur et ralentit s'il détecte une surcharge, pour ne pas dégrader l'expérience de vos vrais visiteurs. La seconde est le besoin de crawl, lié à la popularité de vos URL et à la fréquence à laquelle votre contenu change.
Pour un petit site vitrine de quelques dizaines de pages, la notion de budget de crawl reste largement théorique : Google a les moyens de tout explorer sans effort. En revanche, dès qu'un site grossit — un catalogue e-commerce, un grand média, un annuaire, un site à facettes — la question devient centrale. Si Googlebot passe l'essentiel de son temps sur des pages sans intérêt, il lui en reste d'autant moins pour découvrir et rafraîchir vos pages stratégiques. C'est exactement ce que l'analyse de logs permet de mesurer : la répartition réelle de l'attention du robot sur votre arborescence. Je détaille souvent ces mécanismes lors de mes missions de référencement, car c'est un levier trop rarement exploité.
Ce que révèlent concrètement vos fichiers de logs
Une fois les données nettoyées et regroupées, plusieurs enseignements sautent aux yeux. Le premier, c'est la fréquence de crawl par page ou par type de page. Vous découvrez que Googlebot revient plusieurs fois par jour sur votre page d'accueil et vos grandes catégories, mais qu'il ne visite certaines fiches produit qu'une fois par mois, voire jamais. Cette hiérarchie n'est pas neutre : une page rarement crawlée est une page dont les mises à jour mettent longtemps à être prises en compte, et une page jamais crawlée est tout simplement absente de la course.
Le deuxième enseignement concerne les pages orphelines et oubliées. En croisant la liste des URL présentes dans les logs avec la liste des URL réellement importantes de votre site, on identifie deux angles morts. D'un côté, des pages stratégiques que Google ne visite pas ou très peu, souvent parce qu'elles sont mal maillées en interne. De l'autre, des pages que Google explore alors qu'elles ne devraient pas exister dans l'index : anciennes URL, paramètres de tri, versions dupliquées. Ce croisement entre logs et données de crawl est, pour moi, le cœur du travail. C'est là que se cachent les gains les plus rapides.
Le troisième enseignement porte sur le rythme de découverte des nouveaux contenus. En observant combien de temps s'écoule entre la publication d'une page et son premier passage de Googlebot, on mesure la « réactivité » du site. Un délai qui s'allonge est souvent le signe d'un maillage interne défaillant ou d'un budget de crawl mal réparti. Un bon maillage, pensé dès la création de site internet, réduit considérablement ce délai.
Les codes de réponse HTTP, un diagnostic immédiat
Parmi toutes les colonnes d'un log, celle des codes de réponse est l'une des plus parlantes. Elle indique, pour chaque requête de Googlebot, ce que le serveur a renvoyé. Un code 200 signale une page servie correctement, c'est le cas nominal. Mais les autres codes racontent une histoire souvent négligée. Une proportion élevée de codes 3xx, c'est-à-dire de redirections, indique que le robot dépense son énergie à suivre des sauts au lieu d'atteindre directement le contenu. Des redirections en chaîne, où une URL renvoie vers une autre qui renvoie encore ailleurs, sont particulièrement coûteuses.
Les codes 4xx, et notamment les fameuses erreurs 404, révèlent que Googlebot continue de demander des pages qui n'existent plus. Un peu de 404 est normal sur tout site vivant, mais une masse importante trahit des liens internes cassés ou des URL obsolètes toujours référencées quelque part. Enfin, les codes 5xx sont les plus préoccupants : ils signalent que votre serveur a été incapable de répondre. Répétés, ils poussent Google à réduire sa cadence d'exploration pour vous ménager, ce qui pénalise directement votre visibilité. Repérer un pic de 5xx dans les logs, c'est parfois découvrir un problème d'infrastructure avant même que les visiteurs ne s'en plaignent.
Traduire les logs en actions SEO concrètes
Collecter des données n'a d'intérêt que si l'on en tire des décisions. C'est la partie que je préfère, parce qu'elle transforme un fichier austère en feuille de route. Voici, sous forme de tableau, la manière dont je relie chaque observation tirée des logs à une action de référencement. C'est ce type de grille de lecture que je transmets pendant mes formations SEO, pour que les équipes deviennent autonomes.
| Ce que révèlent les logs | Interprétation | Action SEO recommandée |
|---|---|---|
| Pages stratégiques jamais ou très peu crawlées | Maillage interne insuffisant, profondeur trop élevée | Renforcer les liens internes, remonter la page dans l'arborescence, l'ajouter au sitemap |
| Fort crawl sur des URL à paramètres ou filtres | Gaspillage de budget de crawl sur du contenu dupliqué | Bloquer via robots.txt, canonicaliser, gérer les paramètres d'URL |
| Volume élevé de codes 404 | Liens internes cassés ou anciennes URL toujours sollicitées | Corriger les liens, mettre en place des redirections 301 pertinentes |
| Chaînes de redirections 3xx | Perte de temps et dilution du signal pour le robot | Réduire à une seule redirection directe vers l'URL finale |
| Pics récurrents de codes 5xx | Serveur saturé ou instable, crawl ralenti par Google | Optimiser l'hébergement, la mise en cache et les temps de réponse |
| Crawl encore majoritairement desktop | Site mal adapté à l'index mobile-first | Vérifier la parité de contenu et la performance mobile |
Ce tableau n'a rien de figé, il évolue selon la nature du site. Mais il illustre un principe simple : chaque anomalie de crawl a une contrepartie technique ou éditoriale. Le rôle de l'analyste est de prioriser, car on ne corrige pas tout en même temps. Je commence toujours par ce qui bloque l'accès aux pages qui génèrent du chiffre d'affaires, avant de m'occuper des optimisations plus fines.
Prioriser le crawl vers les pages qui comptent
L'objectif final de toute cette démarche tient en une phrase : faire en sorte que Google consacre son temps à vos pages importantes plutôt qu'à des impasses. Concrètement, cela passe par deux mouvements complémentaires. Le premier consiste à fermer les robinets inutiles. Quand les logs montrent que Googlebot s'épuise sur des milliers de combinaisons de filtres, des calendriers infinis ou des pages de recherche interne, on lui interdit poliment l'accès à ces zones. Moins de gaspillage, c'est mécaniquement plus de budget disponible pour le reste.
Le second mouvement consiste à éclairer le chemin vers les pages prioritaires. Un maillage interne cohérent, des sitemaps XML propres et à jour, une arborescence peu profonde : tout cela envoie au robot des signaux clairs sur ce qui mérite son attention. Les logs servent ici de boucle de contrôle. Après avoir mis en place ces changements, je reviens quelques semaines plus tard vérifier dans les journaux que la fréquence de crawl des pages ciblées a bien augmenté. C'est cette approche itérative, mesurable, que je défends dans mon travail d'expert SEO : on n'optimise pas à l'aveugle, on constate l'effet réel sur le comportement de Google.
Comment mettre en place une analyse de logs
Beaucoup de sites n'exploitent jamais leurs logs, non par manque d'intérêt, mais parce que le sujet semble technique. Il l'est un peu, mais rien d'insurmontable. La première étape consiste à récupérer les fichiers auprès de l'hébergeur. Selon le serveur, ils portent des formats un peu différents mais contiennent toujours les mêmes informations essentielles. L'idéal est de disposer d'une période assez longue, idéalement plusieurs semaines, pour lisser les variations et repérer les tendances de fond plutôt que les accidents ponctuels.
Vient ensuite le traitement des données. Sur un petit volume, un tableur peut suffire pour dégrossir. Au-delà, il devient nécessaire de passer par des outils dédiés à l'analyse de logs, capables d'ingérer des millions de lignes, de vérifier l'authenticité des robots et de croiser automatiquement les données de crawl. L'important n'est pas l'outil en lui-même, mais la rigueur de la méthode : nettoyer, segmenter par type de page, comparer les périodes. Une analyse mal cadrée produit des chiffres impressionnants mais inexploitables.
Enfin, l'analyse de logs n'est pas un exercice ponctuel. Sur un site qui évolue, elle gagne à devenir un suivi régulier, au même titre que le suivi de positions ou de trafic. Une surveillance mensuelle permet de détecter très tôt une dérive : une explosion soudaine de 404 après une refonte, un pic de 5xx lié à un problème d'hébergement, ou une baisse de fréquence de crawl annonçant parfois une perte de visibilité à venir. Anticiper ces signaux, c'est reprendre la main sur son référencement au lieu de le subir.
Un exemple concret de gaspillage de crawl
Pour rendre les choses plus parlantes, prenons un cas de figure que je rencontre très souvent sur les sites e-commerce. Imaginez une boutique dotée d'une navigation à facettes : le visiteur peut filtrer les produits par couleur, par taille, par prix, par marque. Chaque combinaison génère une URL distincte. Multipliez les filtres entre eux et vous obtenez, sans même vous en rendre compte, des dizaines de milliers d'URL quasi identiques. Sur le papier, personne ne les voit. Dans les logs, en revanche, le constat est brutal : Googlebot passe parfois la majorité de son temps à explorer ces variations sans valeur, pendant que les vraies fiches produit attendent leur tour.
La première fois qu'un commerçant découvre cette réalité dans ses propres journaux, la prise de conscience est immédiate. On visualise noir sur blanc que le budget de crawl part en fumée. La correction, elle, tient en quelques décisions : indiquer à Google quelles combinaisons de filtres ignorer, canonicaliser les pages vers leur version de référence, et alléger le maillage vers ces zones. Quelques semaines plus tard, les logs racontent une autre histoire : la part d'exploration consacrée aux fiches produit remonte, et avec elle la fraîcheur de leur indexation. C'est ce type de résultat mesurable qui donne tout son sens à la démarche. On ne parle plus de théorie, mais d'un rééquilibrage visible de l'attention de Google, obtenu sans créer une seule ligne de contenu supplémentaire.
Ce que j'en retiens sur le terrain
Après des années à ausculter des logs pour des sites de toutes tailles, une conviction s'est imposée à moi : l'analyse de logs est le pont entre le SEO technique et le SEO éditorial. Elle réconcilie deux mondes qui s'ignorent trop souvent. Le rédacteur qui se demande pourquoi son article ne décolle pas et l'administrateur système qui optimise ses temps de réponse travaillent en réalité sur le même objectif : rendre le site aisément explorable par Google. Les logs sont le langage commun qui permet de le vérifier.
Ce n'est pas non plus une baguette magique. Un site bien exploré mais au contenu médiocre ne se positionnera pas mieux pour autant. Mais un excellent contenu qui n'est jamais crawlé n'a, lui, aucune chance. L'analyse de logs sécurise cette base : elle garantit que le travail de fond que vous investissez dans vos pages arrive bien jusqu'à Google, au bon rythme et sans obstacle. C'est une assurance discrète, mais décisive, sur la santé de votre visibilité.
Si vous sentez que votre site ne délivre pas tout son potentiel dans les résultats de recherche, ou si vous voulez simplement savoir ce que Google explore vraiment chez vous, une lecture de vos fichiers de logs est souvent le point de départ le plus éclairant. C'est une démarche que je mène régulièrement, avec des recommandations concrètes et priorisées à la clé. N'hésitez pas à me contacter pour en discuter : ensemble, nous transformerons ces fichiers austères en un véritable plan d'action pour votre référencement.